Jak działają kody QR? Do czego służy każda część wzoru
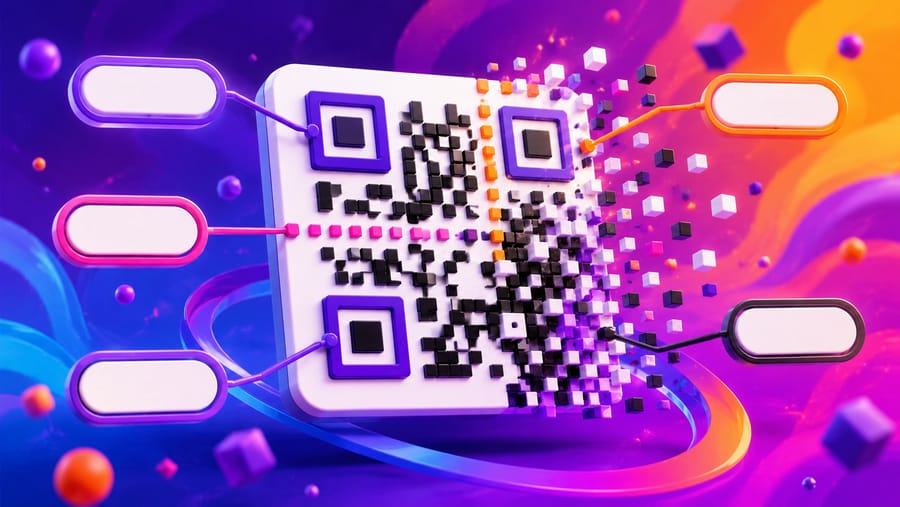
Telefon czyta kod QR w jakąś dziesiątą część sekundy i za każdym razem robi to tak samo: znajduje trzy narożne kwadraty, ustala siatkę, czyta pasek mówiący, jak zakodowana jest reszta, cofa wzór maskujący, a potem składa dane i naprawia to, co zostało uszkodzone.
Każdy kwadracik we wzorze należy do jednego z tych kroków. Oto do którego.
Trzy narożne kwadraty: znalezienie i ustawienie
Duże kwadraty w trzech rogach to znaczniki pozycjonujące. Skaner szuka ich jako pierwszych, a ich proporcja ciemnych i jasnych pasm — 1:1:3:1:1 wzdłuż każdej linii przechodzącej przez środek — jest celowo rzadka w zwykłych obrazach, więc aparat wyłapuje je nawet na zagraconym zdjęciu.
Trzy, a nie cztery, to cała sztuczka: trzy rogi wyznaczają, gdzie jest góra. Dlatego kod czyta się do góry nogami i pod kątem, i dlatego zasłonięcie jednego rogu zabija go od razu, niezależnie od tego, ile korekcji błędów sobie zafundowałeś.
Kropkowane linie: ustawienie siatki
Między znacznikami pozycjonującymi biegną pojedyncze linie na przemian ciemnych i jasnych modułów — wzory taktujące. Mówią skanerowi, ile modułów ma kod w poprzek, żeby mógł nałożyć siatkę na obraz i wiedzieć, gdzie wypada każda komórka. Bez nich lekko obrócone zdjęcie rozjechałoby się w połowie kodu.
Małe kwadraty: poprawka na zakrzywioną powierzchnię
Od wersji drugiej w górę we wnętrzu kodu pojawiają się mniejsze wzory wyrównujące. To punkty odniesienia, dzięki którym skaner cofa zniekształcenie — kod na butelce, na wygiętej etykiecie albo na zdjęciu zrobionym z boku. Im większy kod, tym więcej ich niesie.
Pasek przy rogach: ustawienia
Wokół znaczników pozycjonujących owinięta jest informacja o formacie: poziom korekcji błędów i to, który z ośmiu wzorów maskujących został zastosowany. Czyta się ją przed danymi, bo bez niej danych nie da się zinterpretować. Ma własną drobną ochronę, niezależną od wybranego poziomu — i dlatego słynne „30% uszkodzeń” nigdy jej nie dotyczyło.
Maskowanie: dlaczego dwa kody do tego samego linku wyglądają inaczej
Surowe zakodowane dane często dają wielkie puste pola albo pasy, a te mylą aparat — gorzej, potrafią udawać znacznik pozycjonujący. Koder robi więc XOR danych z jednym z ośmiu wzorów maskujących, punktuje wynik za niepożądane cechy i zostawia najlepszy.
Dlatego ten sam adres daje w różnych narzędziach widocznie różne wzory i dlatego z układu kropek nie „odczytasz” okiem niczego.
Jak rozłożone są dane
Dane zapisuje się w kolumnach szerokich na dwa moduły, zaczynając od prawego dolnego rogu i wężykiem w górę, potem w dół, potem w górę — dookoła wzorów funkcyjnych, nigdy przez nie. Istnieją cztery tryby kodowania, a koder wybiera najciaśniejszy, który się mieści: numeryczny, alfanumeryczny, bajtowy (obejmujący zwykłe adresy) i kanji.
Rozmiar wyraża się jako wersję, od 1 do 40 — od 21×21 modułów do 177×177, cztery moduły na bok więcej na każdym kroku. Na samym szczycie kod w wersji 40 z najniższą korekcją błędów mieści około 7089 cyfr albo 4296 znaków alfanumerycznych. W praktyce nikt tego nie drukuje: to gęsta siatka, której żaden aparat telefonu nie rozróżni przy rozsądnej wielkości.
Korekcja błędów: druga kopia
Częścią każdego kodu są dane naprawcze Reeda-Solomona — matematyczna druga kopia, która pozwala skanerowi odbudować to, czego nie umie odczytać. Poziomy są cztery: mniej więcej 7%, 15%, 25% i 30% powierzchni danych do odzyskania, od L do H.
To właśnie ten zapas płaci za logo na środku, za rysę, za deszcz na naklejce. To także powód, dla którego wyższy poziom zagęszcza wzór: dane naprawcze muszą się gdzieś zmieścić.
Biały margines jest częścią kodu
Cisza — cztery moduły wolnej przestrzeni dookoła — nie jest ozdobą. To po niej skaner poznaje, gdzie kończy się kod, a zaczyna świat. Ozdobna ramka dorysowana tuż przy wzorze ją kasuje, i to jeden z najczęstszych powodów, dla których piękny wydrukowany kod się nie skanuje.
Co naprawdę zawiera kod dynamiczny
Częste nieporozumienie brzmi, że dynamiczny kod QR przechowuje twój cel i jakoś sam się aktualizuje. Nie potrafi: wzór jest zamrożony w chwili druku.
Zapisany jest w nim krótki link — domena i garść znaków. Zeskanowanie otwiera ten krótki link, który przekierowuje tam, gdzie kod akurat wskazuje. Zmieniasz cel i wszystkie wydrukowane egzemplarze idą za nim, bo w wydrukowanym wzorze nic zmieniać się nie musi.
Jest przy tym praktyczny efekt uboczny wart zapamiętania: skoro krótki link to tylko kilkadziesiąt znaków, kod zostaje w niskiej wersji z dużymi, odpornymi modułami. Kod statyczny niosący długi adres z parametrami kampanii potrzebuje przy tej samej wielkości fizycznej znacznie gęstszej siatki — i to dokładnie ten kod zawodzi na plakacie.
Szybkie odpowiedzi
- Czym są trzy duże kwadraty? Znacznikami pozycjonującymi. Pozwalają skanerowi znaleźć kod i ustalić jego orientację.
- Dlaczego kod czyta się do góry nogami? Bo trzy rogi wystarczą, żeby wyznaczyć, gdzie jest góra.
- Czym są małe kwadraty w środku? Wzorami wyrównującymi, które poprawiają zniekształcenie na zakrzywionych i ustawionych pod kątem powierzchniach.
- Dlaczego dwa kody do tego samego linku wyglądają inaczej? Przez maskowanie. Koder bierze ten z ośmiu wzorów, który wypada najlepiej.
- Ile mieści się danych? Do jakichś 7089 cyfr przy największej wersji i najniższej korekcji błędów — dużo więcej, niż da się sensownie wydrukować.
- Czy biały margines jest opcjonalny? Nie. To po ciszy skaner rozpoznaje krawędzie kodu.
- Czy kod dynamiczny przechowuje mój link? Nie. Przechowuje krótki link, który przekierowuje, i dlatego cel zmienia się bez przedruku.
Zespół Enqre·Opublikowano 22.09.2026