Como funcionam os códigos QR? Para que serve cada parte do padrão
Um telemóvel lê um código QR em cerca de um décimo de segundo, e o processo é sempre o mesmo: encontrar os três quadrados dos cantos, deduzir a grelha, ler uma faixa que diz como está codificado o resto, desfazer um padrão de mascaramento e, por fim, remontar os dados e reparar o que estiver danificado.
Cada quadrado do padrão pertence a um desses passos. Fica aqui a qual.
Os três quadrados dos cantos: encontrar e orientar
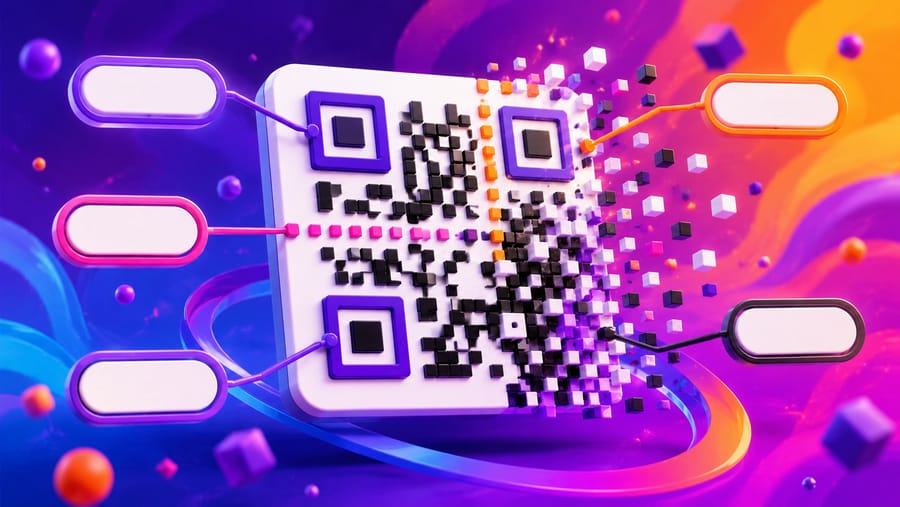
Os quadrados grandes em três cantos são os padrões de localização. São a primeira coisa que um leitor procura, e a sua proporção de faixas escuras e claras — 1:1:3:1:1 ao longo de qualquer linha que passe pelo meio — é propositadamente rara em imagens comuns, para que a câmara os detete numa fotografia atafulhada.
Três, e não quatro, é o truque todo: três cantos definem qual é o lado de cima. É por isso que um código lê ao contrário e na diagonal, e é por isso que tapar um canto o mata de imediato, por muita correção de erros que se tenha pago.
As linhas pontilhadas: fixar a grelha
Entre os padrões de localização correm linhas simples de módulos escuros e claros alternados — os padrões de sincronismo. Dizem ao leitor quantos módulos o código tem de largura, para poder assentar uma grelha sobre a imagem e saber onde cai cada célula. Sem eles, uma fotografia ligeiramente rodada perderia o alinhamento a meio do código.
Os quadrados pequenos: corrigir uma superfície curva
A partir da versão 2, aparecem dentro do corpo do código padrões de alinhamento mais pequenos. São pontos de referência que permitem ao leitor desfazer a distorção — um código numa garrafa, num rótulo curvo, ou numa fotografia tirada de lado. Quanto maior o código, mais deles transporta.
A faixa ao lado dos cantos: as definições
Enrolada à volta dos padrões de localização está a informação de formato: o nível de correção de erros e qual dos oito padrões de máscara foi aplicado. Lê-se antes dos dados, porque sem ela os dados não se conseguem interpretar. Tem a sua própria proteção, separada do nível escolhido — razão pela qual o famoso «30 % de danos» nunca se lhe aplicou.
Mascaramento: porque é que dois códigos para a mesma ligação são diferentes
Os dados codificados em bruto produzem muitas vezes grandes áreas vazias ou riscas, e isso confunde a câmara — pior, pode imitar um padrão de localização. Por isso o codificador faz XOR dos dados com um de oito padrões de máscara, pontua o resultado quanto a características indesejáveis e fica com o melhor.
É por isso que o mesmo endereço produz padrões visivelmente diferentes em ferramentas diferentes, e é por isso que não se «lê» nada a olho na disposição dos pontos.
Como os dados são dispostos
Os dados escrevem-se em colunas com dois módulos de largura, começando no canto inferior direito e serpenteando para cima, depois para baixo, depois para cima — à volta dos padrões de função, nunca através deles. Existem quatro modos de codificação, e o codificador escolhe o mais apertado que sirva: numérico, alfanumérico, byte (que cobre os endereços comuns) e kanji.
O tamanho exprime-se como versão, de 1 a 40 — de 21×21 módulos até 177×177, mais quatro módulos por lado em cada degrau. No topo, um código de versão 40 com a correção de erros mais baixa leva cerca de 7089 dígitos ou 4296 caracteres alfanuméricos. Na prática ninguém imprime isso: é uma grelha densa que nenhuma câmara de telemóvel resolve a um tamanho sensato.
Correção de erros: a segunda cópia
Parte de cada código são dados de recuperação Reed-Solomon — uma segunda cópia matemática que permite ao leitor reconstruir o que não consegue ler. Há quatro níveis: cerca de 7 %, 15 %, 25 % e 30 % da área de dados recuperável, de L a H.
É essa dotação que paga um logótipo ao meio, um risco, chuva sobre um autocolante. É também a razão por que um nível mais alto torna o padrão mais denso: os dados de recuperação têm de caber algures.
A margem branca faz parte do código
A zona de silêncio — quatro módulos de espaço livre em redor — não é enfeite. É assim que o leitor sabe onde acaba o código e começa o mundo. Uma moldura decorativa desenhada rente ao padrão elimina-a, e esta é uma das razões mais frequentes para um belo código impresso não ler.
O que um código dinâmico contém de facto
Um equívoco comum é achar que um código QR dinâmico guarda o destino e se atualiza sozinho. Não pode: o padrão fica fixo no momento em que é impresso.
O que ele grava é uma ligação curta — um domínio e um punhado de caracteres. Lê-lo abre essa ligação curta, que reencaminha para onde o código aponta naquele momento. Muda-se o destino e todos os exemplares impressos acompanham, porque no padrão impresso não há nada que mude.
Há um efeito secundário prático que vale a pena saber: como uma ligação curta tem apenas algumas dezenas de caracteres, o código mantém-se numa versão baixa, com módulos grandes e robustos. Um código estático a transportar um endereço comprido com parâmetros de campanha precisa de uma grelha muito mais densa para o mesmo tamanho físico — e é exatamente esse o código que falha num cartaz.
Respostas rápidas
- O que são os três quadrados grandes? Padrões de localização. Permitem ao leitor encontrar o código e perceber a sua orientação.
- Porque é que um código lê ao contrário? Porque três cantos chegam para definir qual é o lado de cima.
- O que são os quadrados pequenos lá dentro? Padrões de alinhamento, que corrigem a distorção em superfícies curvas ou inclinadas.
- Porque é que dois códigos para a mesma ligação são diferentes? Mascaramento. O codificador escolhe o que pontua melhor entre oito padrões.
- Quantos dados cabem? Até cerca de 7089 dígitos na maior versão e na correção de erros mais baixa — muito mais do que é prático imprimir.
- A margem branca é opcional? Não. É pela zona de silêncio que o leitor encontra os limites do código.
- Um código dinâmico guarda a minha ligação? Não. Guarda uma ligação curta que reencaminha, e é por isso que o destino muda sem reimprimir.
A equipa Enqre·Publicado a 22/09/2026